月曜の朝、先週の数字を集めて、表にまとめて、会議用の報告書をつくる。
AIに文章を書いてもらっても、数字を探すのは自分。Excelに移すのも自分。最後に合計が合わず、元の資料を開き直す。こんな仕事を想像すると、新しいAIに期待したいことが少しはっきりします。文章を出したあとに残る作業まで、手伝ってほしい。
GPT-6 Astraの公式発表で注目したのは、まさにこの部分でした。OpenAIはPC操作や開発、複数の工程を伴う仕事の改善を打ち出しています。試すなら、これまで人が何度も手を入れていた仕事を一つ選ぶ。そこに今回のアップデートを確かめる意味があると考えます。
いちばん差が開いたのは、どんなテストか
GPT-5.6 Solとの比較から、三つだけ取り出しました。上段が何を測るテストか、下段が公表スコアです。
37.3%→57.9%
65.7%→72.6%
94.6%→96.0%
Terminal-Benchは20.6ポイントの上昇。GPQAは1.4ポイントです。もともとの点数も問題の種類も違うので、改善幅だけで難易度は比べられません。それでも「知識問題の正答率が上がった」という話だけでは、今回の変化を捉えきれないことが分かります。
仕事に置き換えるなら、難しい質問を一つ聞くほかに、資料を集めて、加工して、成果物にする一連の作業でも確かめたい。冒頭の週次報告や、修正後の動作確認まで必要な開発は、その候補です。
スコアの出典・測定条件
OpenAI公式発表の比較表から抜粋。各推論設定の最高値で、同じ費用・待ち時間にそろえた比較ではありません。SolはAPI・Codex・ChatGPT Workの版。OSWorldはv2026.08.08、offline set、partial scoreです。研究環境・APIでの結果であり、BloomAIの独自実測ではありません。
「99.9%」より気になった、脚注の話
発表には、ARC-AGI-3で99.9%という目を引く数字もあります。ただ、読む価値があるのは脚注も含めてです。AstraではOpenAIのResponses API用の実行環境が使われています。公式発表・脚注1
なぜ実行環境が大事なのか。同社の別の検証では、Solのモデルを変えず、推論の保持と履歴の圧縮を有効にしただけで、同じ公開タスク群のスコアが13.3%から38.3%へ変わっています。OpenAIの検証記事
これはAstraの99.9%とは別の条件の数字です。ここから読み取れるのは、AIの性能には「前に何をしたかを覚えておけるか」も関係する、ということ。
実務でも、長い作業の途中で前提が抜ければやり直しになります。新モデルを試すときは、一問一答の感触に加えて、最後まで依頼の条件を守れたかを見たいところです。
そのまま試せる、週次報告のミニ課題
「自社の仕事で比べる」と言っても、準備から始めると後回しになりがちです。そこで、BloomAIで比較用の小さな課題を用意しました。以下はすべて架空の数字です。モデルの優劣を実測した結果ではありません。
商品,前週売上円,今週売上円,今週の記録
A,100000,120000,広告配信を開始
B,80000,60000,記録なし
C,20000,30000,記録なし
このデータと、次の依頼をSolとAstraそれぞれの新しい会話へ渡します。利用するアプリ・ツール・推論設定も記録してください。ツールが違う場合は、モデル単体ではなく利用環境を含めた比較になります。
会議用の週次報告を作ってください。商品ごとの売上差額と増減率、全商品の合計を表にしてください。増減率は小数第1位まで。最後に、分かっていることと追加確認が必要なことを、それぞれ2点以内で書いてください。記録と原因の推測を分け、資料にない事情を補わないでください。
確認する答えは決まっています。Aは2万円増・20.0%増、Bは2万円減・25.0%減、Cは1万円増・50.0%増。合計は20万円から21万円へ、全体では5.0%増です。商品の増減率を単純平均すると15.0%になりますが、それは全体の増減率ではありません。
もう一つ見たいのは、Aの説明です。「広告配信を始めた」は記録にある事実。ただし、この資料だけでは「広告が売上を伸ばした」とまでは言えません。数字が合っていても、原因を作ってしまう報告書は、そのまま会議に出せません。
- 数字を見る合計は21万円
全体の増加率は5.0% - 説明を見る広告開始は事実
売上増の原因は未確定
計算の正しさと、根拠のある説明。両方がそろって初めて報告に使えます。
採点は「計算」「事実と推測の区別」「依頼した形式」の3項目を、各1点。 点数とは別に、使える報告に直すまで何分かかったかを残します。一度の成功で決めず、別の数字や欠損のあるデータでも試すと、任せられる範囲が見えてきます。この課題は基本動作の確認用なので、両方が満点なら実際につまずいている工程を足して比べてください。
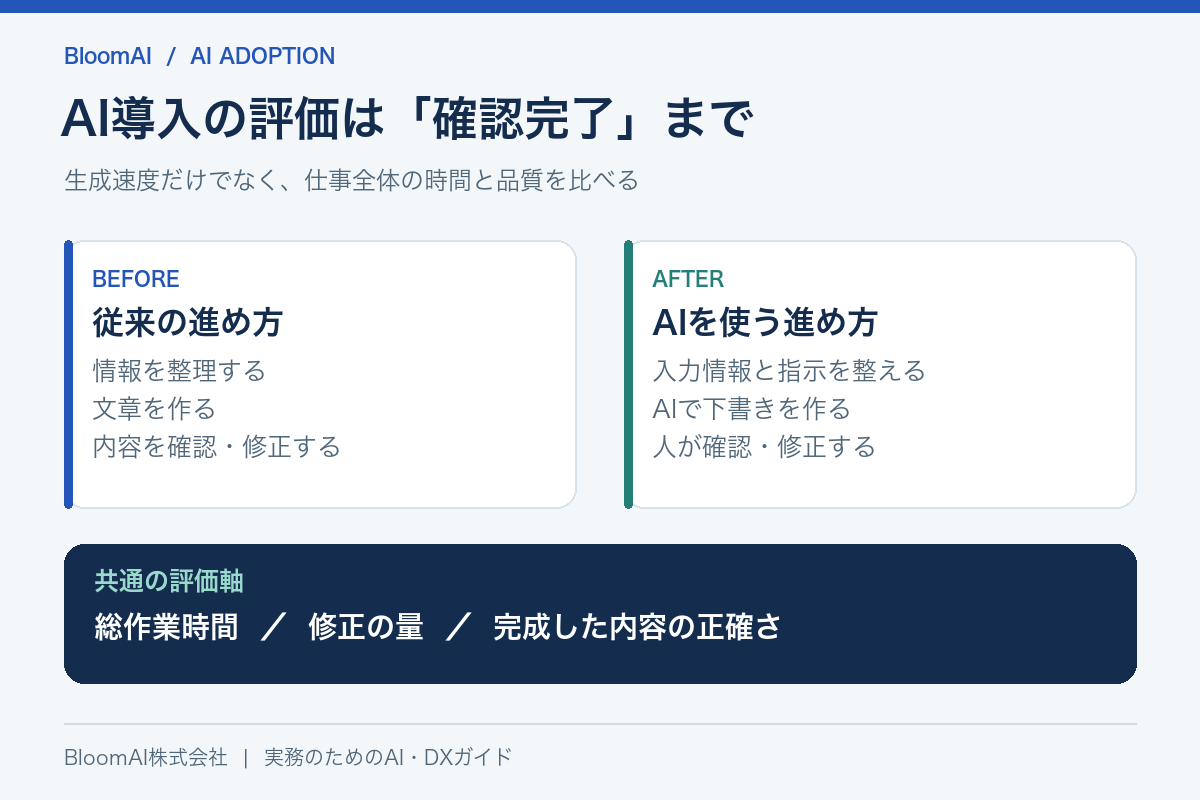
ここで手直しがほとんど変わらないなら、その仕事ではSolを続ける判断もできます。新モデルへの切り替えを決める材料は、見栄えの良い一回答より、毎週の確認がどれだけ楽になるかです。
APIで使う人は、長い資料の料金に注意
アプリで使う人と、自社システムへAPIを組み込む人では、見る料金が違います。以下はAPIの標準単価です。
| 100万トークン当たり | 料金 |
|---|---|
| 通常の入力 | 10米ドル |
| 出力 | 50米ドル |
| キャッシュ読み込み | 1米ドル |
| キャッシュ書き込み | 12.50米ドル |
入力が272Kトークンを超えると、そのリクエスト全体で入力・キャッシュは2倍、出力は1.5倍になります。最大1,050,000トークンを扱えることと、長い資料を安く処理できることは別に考える必要があります。OpenAI API仕様・料金
見積もるなら、課金対象の入力が1万、出力が2千トークンの場合、通常のテキスト料金は0.20米ドル。実際には推論に使うトークン、再試行、ツール料金も含めて確認します。ChatGPTの月額料金とは別の計算です。
モデル選びは、手直しが減ったかで決めたい
新しいモデルが出ると、全部の仕事を移したくなるかもしれません。まず一つ、時間を取られている仕事で違いを見れば十分です。
下書きを受け取ってから、使える状態にするまでが短くなったか。これならベンチマークの名前に詳しくなくても、自社にとっての価値を判断できます。
Claudeも候補なら、Fable 5.1とOpus 5の使い分けもどうぞ。試す業務を決めるところから整理したい方には、AI導入の始め方で手順を紹介しています。
情報確認:2026年9月12日。公式資料をもとに、BloomAIの視点で業務への当てはめ方を解説しています。
自社の取り組みを具体化したい方へ
事業や業務の課題を整理し、AIを活用するテーマと進め方を具体化。導入後の活用まで見据えて、取り組みを支援します。
AIコンサルティングの支援内容を見る ↗